We onderzoeken uitvoerig waarom dingen misgaan. Maar hoeveel weten we eigenlijk over de duizenden keren dat het goed gaat? Misschien ligt daar wel een van de belangrijkste, en minst onderzochte, bronnen van kennis over veiligheid.
Een operatie zonder bijzonderheden
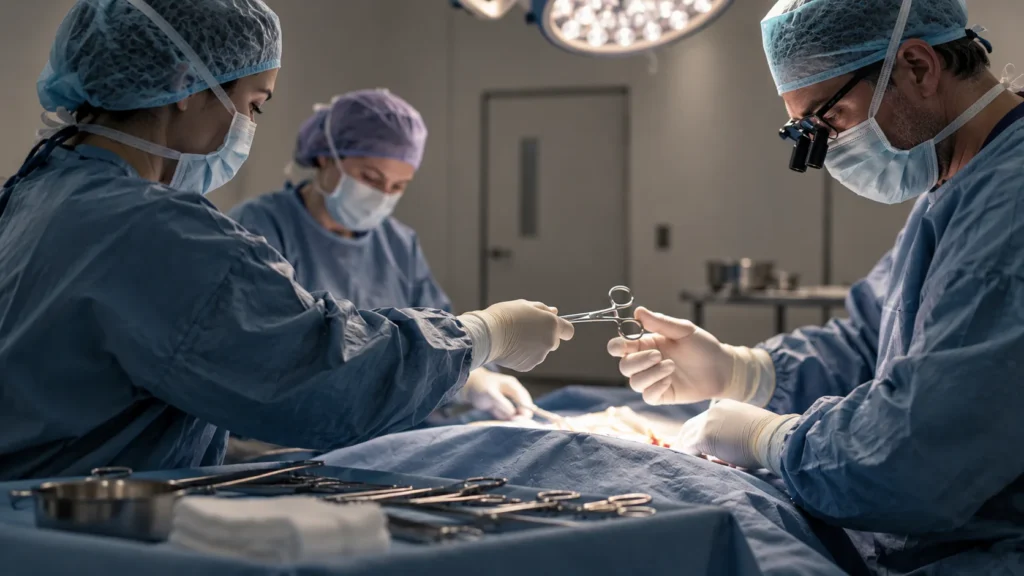
Stel je een operatiekamer voor. De patiënt ligt op tafel, de instrumenten zijn klaargelegd en het operatieteam is begonnen aan een ingreep die het al tientallen keren heeft uitgevoerd.
Tijdens de operatie blijkt extra materiaal nodig. De omloopverpleegkundige zorgt dat het beschikbaar komt, terwijl de instrumenterende verpleegkundige anticipeert op wat de chirurg nodig zal hebben. Even later vraagt de anesthesioloog om een korte onderbreking vanwege een verandering in de toestand van de patiënt. Het team stemt af, past het tempo aan en gaat verder.
Er gebeurt niets spectaculairs. Niemand verricht een heldendaad. Het zijn kleine aanpassingen, zoals die voortdurend plaatsvinden wanneer professionals hun werk doen.
Enkele uren later wordt de patiënt naar de verkoeverkamer gebracht. De operatie is goed verlopen. Het team maakt zich klaar voor de volgende patiënt.
Er volgt geen incidentmelding, geen reconstructie en geen uitgebreide analyse van alle beslissingen die gedurende de operatie zijn genomen.
Waarom zou je ook?
Alles is toch goed gegaan?
Het grootste deel van het werk blijft buiten beeld
In veel organisaties weten we opvallend veel over wat er misgaat. Incidenten worden geregistreerd, oorzaken onderzocht en verbetermaatregelen vastgesteld. We besteden er vergaderingen aan, ontwikkelen procedures en proberen met indicatoren vast te stellen of het veiliger wordt.
Dat is begrijpelijk. Wanneer iemand gewond raakt of een systeem faalt, willen we weten hoe dat kon gebeuren en hoe we herhaling kunnen voorkomen.
Maar daarmee ontstaat een merkwaardige verhouding tussen wat we onderzoeken en wat we proberen te begrijpen.
Een organisatie kan duizenden werkzaamheden succesvol uitvoeren en één ernstig incident meemaken. De aandacht gaat vrijwel volledig naar dat ene incident, terwijl juist die duizenden andere werkzaamheden misschien veel vertellen over het functioneren van de organisatie.
Waarom lukte het al die andere keren wel?
In de veiligheidswetenschappen wordt hiervoor het begrip Normal Work gebruikt: het gewone, dagelijkse werk waarin mensen hun taken uitvoeren, problemen tegenkomen, beslissingen nemen en voortdurend inspelen op veranderende omstandigheden.
Dat werk is veel minder voorspelbaar dan het woord normaal doet vermoeden. Het bestaat uit kleine verstoringen, onverwachte situaties en aanpassingen die meestal nauwelijks opvallen. Juist doordat mensen daarmee weten om te gaan, kan het werk doorgaan.
Het gebruikelijke antwoord op de vraag waarom het goed ging, is dat medewerkers hun werk goed deden, procedures volgden en de veiligheidsmaatregelen functioneerden.
Maar is dat werkelijk een verklaring?
Wie Normal Work van dichtbij bekijkt, ziet dat de werkelijkheid zelden precies verloopt zoals vooraf bedacht. Materialen zijn niet altijd beschikbaar wanneer ze nodig zijn. Informatie komt later dan verwacht. Werkzaamheden duren langer, omstandigheden veranderen en mensen zijn voor hun werk afhankelijk van anderen die op datzelfde moment hun eigen problemen proberen op te lossen.
Toch lukt het meestal om het werk gedaan te krijgen.
Dat komt mede doordat mensen voortdurend waarnemen, overleggen, anticiperen en hun handelen aanpassen aan wat de situatie vraagt. Veel van die aanpassingen zijn zo vanzelfsprekend geworden dat we ze nauwelijks nog herkennen als onderdeel van het veilig functioneren van de organisatie.
Ze verdwijnen in het resultaat.
De mensen die het systeem laten werken
Erik Hollnagel stelde een interessante vraag bij de manier waarop we traditioneel naar veiligheid kijken.
Wanneer veiligheid vooral wordt beschouwd als de afwezigheid van incidenten, richten we onze aandacht vanzelf op wat verkeerd gaat. Die benadering noemt hij Safety-I.
Maar het uitblijven van een ongeval vertelt ons nog niet hoe veiligheid daadwerkelijk tot stand komt.
Hollnagel introduceerde daarom het perspectief van Safety-II: veiligheid begrijpen vanuit het vermogen van een organisatie om onder wisselende omstandigheden succesvol te functioneren.
Daarmee verandert ook de betekenis van menselijk handelen.
In een traditionele benadering wordt variatie in het handelen van mensen vaak gezien als iets wat beheerst moet worden. Procedures beschrijven hoe het werk hoort te verlopen en afwijkingen daarvan vormen een mogelijk risico.
Maar variatie is ook noodzakelijk. Geen enkele procedure kan vooraf alle omstandigheden beschrijven waarmee mensen tijdens hun werk te maken krijgen. Professionals moeten voortdurend interpreteren wat de situatie vraagt en hoe de beschikbare afspraken en middelen daarbij helpen.
Dat betekent niet dat procedures overbodig zijn. Ze bieden structuur, ondersteunen samenwerking en leggen belangrijke kennis vast. Maar ook de beste procedure moet in de werkelijkheid worden toegepast, en die werkelijkheid is nooit helemaal dezelfde.
Juist dat samenspel tussen procedures, omstandigheden en menselijk vakmanschap verdient onze aandacht.
Want de aanpassingen die vandaag bijdragen aan een goede afloop, kunnen morgen onder andere omstandigheden onvoldoende blijken.
Dezelfde manier van werken kan dus zowel bijdragen aan succes als een rol spelen bij het ontstaan van een incident.
Wanneer succes een kwetsbaarheid verbergt
Er zit nog iets ongemakkelijks aan de constatering dat het meestal goed gaat.
Een goede afloop betekent niet automatisch dat een organisatie goed is ingericht.
Misschien lukt het werk alleen doordat medewerkers voortdurend problemen opvangen die eigenlijk structureel opgelost zouden moeten worden. Misschien zijn zij gewend geraakt aan ontbrekende informatie, te krappe planningen of apparatuur die niet goed aansluit op de werkzaamheden.
Ze vinden oplossingen, stemmen onderling af en zorgen dat het werk doorgaat.
De organisatie ziet een goed resultaat.
Maar hoeveel inspanning was daarvoor nodig? En wat gebeurt er wanneer de omstandigheden nog iets moeilijker worden?
David Woods beschrijft hoe het aanpassingsvermogen van een systeem grenzen kent. Mensen en organisaties kunnen verstoringen opvangen en hun werkwijze aanpassen, maar die mogelijkheden zijn niet onbeperkt. Wanneer de belasting toeneemt en de beschikbare ruimte om bij te sturen kleiner wordt, kan een systeem dat jarenlang goed functioneerde plotseling kwetsbaar blijken.
Dat maakt het interessant om juist Normal Work te onderzoeken. Ook wanneer er geen incident heeft plaatsgevonden.
Want normaal betekent niet automatisch veilig. Sommige kwetsbaarheden zijn zo verweven geraakt met het dagelijkse werk dat niemand ze nog als bijzonder ervaart.
Een organisatie waarin medewerkers voortdurend moeten improviseren om het werk voor elkaar te krijgen, kan van buitenaf uitstekend functioneren.
Totdat er een keer niet genoeg ruimte meer is om het volgende probleem op te vangen.
Leren zonder dat er eerst iets misgaat
Wat zou er gebeuren wanneer we een gewone werkdag met dezelfde nieuwsgierigheid onderzoeken als een ernstig incident?
Bij Fish Climbing Trees doen we dat onder andere met gesprekken over Work as Done en Learning Teams. We gaan met de mensen die het werk uitvoeren op zoek naar wat er daadwerkelijk gebeurt.
Normal Work vormt daarbij een waardevolle bron van informatie. We onderzoeken hoe mensen hun dagelijkse werkzaamheden uitvoeren, welke omstandigheden ze tegenkomen en wat er nodig is om tot een goed resultaat te komen.
Daarbij kijken we ook naar het verschil tussen Work as Imagined, het werk zoals het vooraf is bedacht, en Work as Done, het werk zoals het in werkelijkheid plaatsvindt.
Waar moest vandaag worden bijgestuurd? Welke problemen werden opgelost voordat iemand anders ze opmerkte? Welke afspraken hielpen, en waar moesten mensen zelf iets bedenken? Wat maakte het mogelijk om ondanks alle verstoringen toch goed en veilig te werken?
Die gesprekken leveren vaak een rijker beeld op van het dagelijkse functioneren van een organisatie dan de beschrijving van een werkproces op papier.
Ze kunnen ook zichtbaar maken welke aanpassingen veel van medewerkers vragen, waar afhankelijkheden kwetsbaar zijn en welke mogelijkheden er bestaan om het werk beter te ondersteunen.
Daarmee wordt leren van veiligheid iets wat niet hoeft te wachten op een ongewenste gebeurtenis.
Het dagelijkse werk biedt daar iedere dag gelegenheid voor.
Wat zien we wanneer we anders kijken?
Terug naar de operatiekamer.
De patiënt is veilig terug op de afdeling. Het operatieteam heeft zijn werk gedaan en bereidt zich voor op de volgende ingreep.
Vanuit het perspectief van de organisatie is er weinig aanleiding om terug te kijken. De operatie is immers goed verlopen.
Maar stel dat we dat wel zouden doen. Dat we het team zouden vragen hoe de ingreep werkelijk verliep, welke aanpassingen nodig waren en wat hen hielp om met onverwachte omstandigheden om te gaan.
Misschien ontdekken we dat de samenwerking uitstekend functioneerde. Misschien blijkt dat er steeds opnieuw dezelfde problemen moeten worden opgelost. Of misschien zien we dat het goede resultaat afhankelijk was van mensen die nauwelijks nog ruimte hadden om verdere verstoringen op te vangen.
Dat weten we pas wanneer we het onderzoeken.
Zolang we een goede afloop vanzelfsprekend vinden, blijft veel van het werk dat die afloop mogelijk maakte onzichtbaar.
En misschien is dat wel de belangrijkste reden om vaker de vraag te stellen:
Waarom gaat het eigenlijk zo vaak goed?
Bronnen
- Hollnagel, E. (2014). Safety-I and Safety-II: The Past and Future of Safety Management. Farnham: Ashgate. routledge.com
- Woods, D. D. (2018). The theory of graceful extensibility: basic rules that govern adaptive systems. Environment Systems and Decisions, 38(4), 433–457. doi.org/10.1007/s10669-018-9708-3